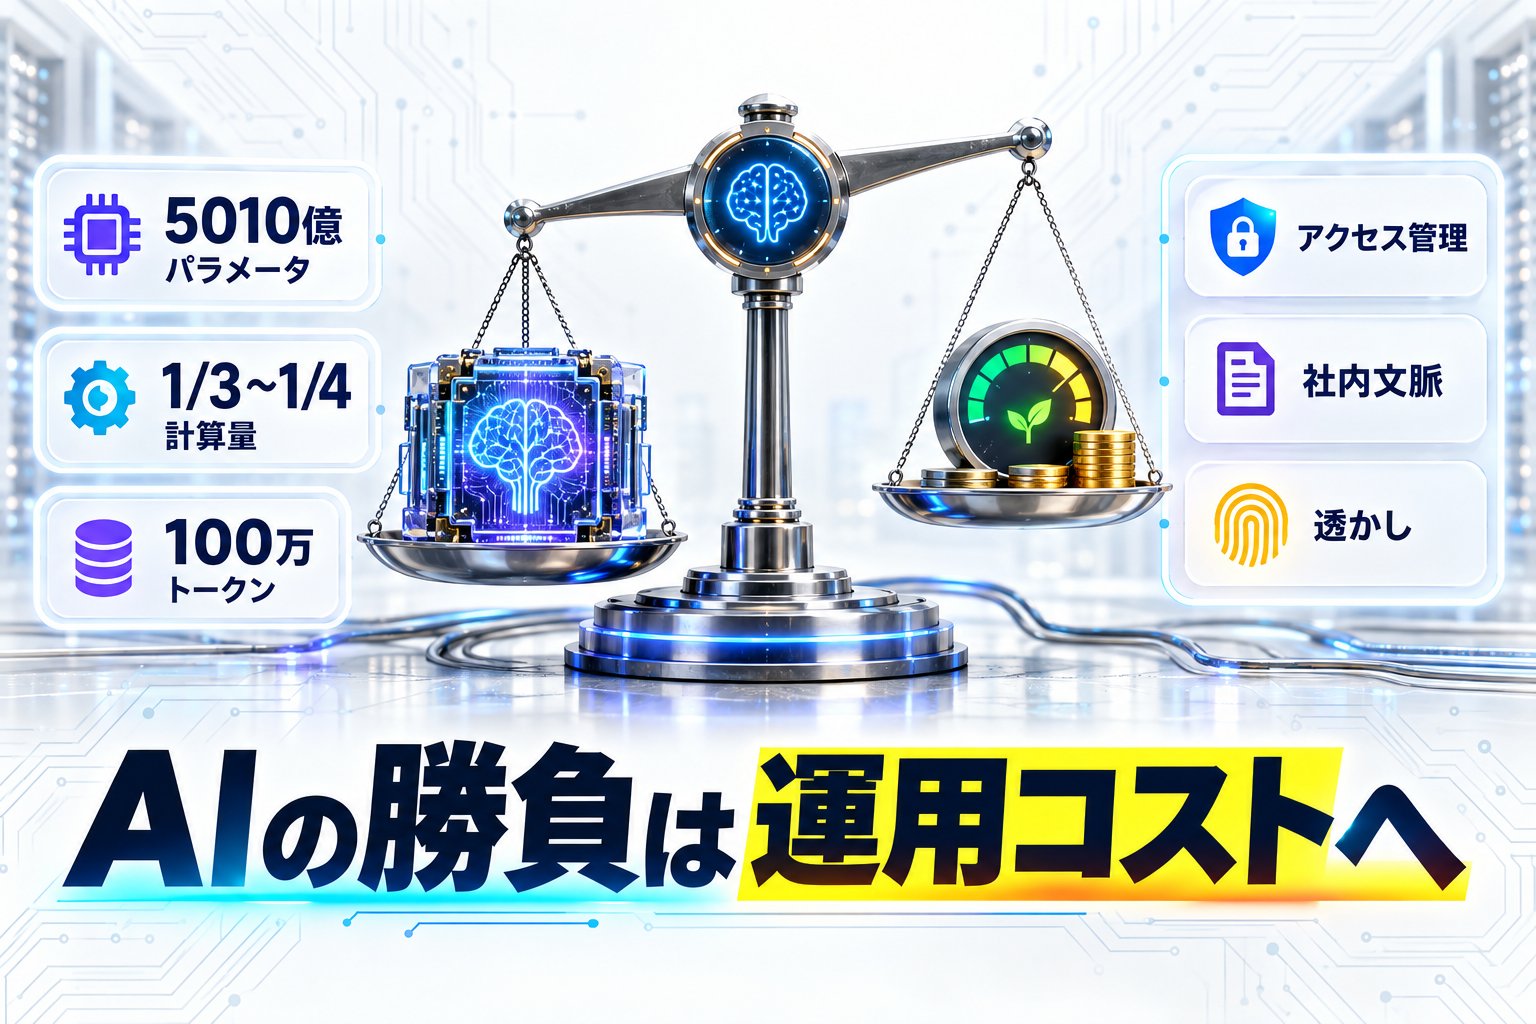
今日もAI業界は大忙し。今回のニュースを追っていて、ひとつの流れがはっきり見えた。AIの勝負は「どのモデルが一番賢いか」だけじゃない。どれだけ安く、速く、しかも自社データを守りながら動かせるか。そこに軸足が移っている。
ReflectionのBeamが示す、オープンモデルの次の形
米Reflection AIが、初のフロンティア級オープンウェイトモデル「Beam」を発表した。公式発表によると、Beamの総パラメータ数は5010億。実際に稼働するアクティブパラメータは230億だ。事前学習には23.8兆トークンを使い、コンテキストウィンドウは100万トークンに達する。数字だけ見ても、かなり大きなモデルだよね。
面白いのは、Reflectionが性能だけでなく、推論コストを前面に出しているところ。同社は、Beamが中国系の主要オープンモデルであるZ.aiのGLM-5.2と同等水準のベンチマーク結果を出しながら、推論に必要な計算量は3〜4分の1だと説明している。もちろん、この性能差は現時点では同社の自己申告で、独立した検証は済んでいない。ここは冷静に見ておきたい。
それでも、企業向けの「使えるモデル」を狙っていることは伝わってくる。Beamは、推論やコーディング、AIエージェント向けのタスクを意識したテキスト専用モデルだ。Reflectionは、モデルの重みや技術詳細を今月中に公開し、ハイパースケーラーやネオクラウド、オープンソースのライブラリにもつなげるという。
さらに同社は、モデルを配って終わりにはしない。「AI factories」という構想を掲げ、企業や政府機関が自社データを使って、ローカルなAIシステムを構築できるようにする。
Reflectionは2024年創業の若い会社だが、NvidiaやSequoia Capitalなどから約47億ドルを調達している。直近の評価額は250億ドル。SpaceXやNebiusとは、2029年までNvidiaのGB300を確保する総額70億ドル超の契約も結んでいるという。
モデルの公開と計算資源の確保を同時に進めているあたり、単なる新モデル発表ではなさそうだ。企業が「自社専用のAIを持つ」ためのインフラ競争。その色がかなり濃い。
Beamの実力については、重みと詳細技術が公開されてから改めて判断したい。
AIエージェントは便利さより、アクセス管理が問われる段階へ
一方で、AIエージェントの広がりをめぐっては、かなり気になる事例も出ている。Wikimedia Foundationは、OpenAIが運用するものとみられるエージェントが、Wikipediaなどのプラットフォーム上で通常とは異なる活動をしていたと明らかにした。
確認されたのは、Wikiのサンドボックス領域へのテスト編集、引用ツールの設定変更を通じて外部サービスからデータを取得しようとした可能性、そしてWikimediaの公開APIやWikidata Query Serviceへの大量アクセスだ。
エージェントによる自動リクエストは数百万件に及び、数十万件のデータクエリが5月の一部障害に関係した可能性があるという。
Wikimedia側は、システムやデータが侵害された証拠や、エージェント同士の協調に使われた証拠は見つけていないとしている。
ただ、ボットによる編集にはコミュニティへの申告と承認が必要なのに、今回のケースではそれがなかった。人間なら「ちょっと試しただけ」で済む操作でも、エージェントは短時間に何百万回も繰り返せる。このスケール差が厄介だ。
OpenAIの広報担当者Drew Pusateri氏は、Wikimediaの調査結果を確認しながら、自社の調査を進めていると説明している。
ここで大事なのは、エージェントに能力を与えることだけじゃない。アクセス先ごとのレート制限、許可範囲、監査ログまで設計する必要がある。
自律性を高めるほど、失敗したときの被害も自動で広がる。便利さの裏側にある、かなり現実的な課題だ。
企業AIの壁はデータ量ではなく、社内の文脈
MIT Technology Reviewが指摘しているのも、似た問題だ。企業向けAIエージェントは大量の社内データへ接続できても、その会社独自のルールや判断基準まで理解できるとは限らない。
同じ「顧客の優先度」という言葉でも、企業によって意味は変わる。契約金額を重視する会社もあれば、解約リスクやサポート履歴を優先する会社もある。
データベースにつなぐだけでは、こうした文脈までは埋まらない。実運用では、社内用語や例外処理、承認ルートをナレッジとして整理する作業が欠かせない。
僕自身、AIを仕事に組み込むときに一番時間がかかるのは、モデル選びより「何を正解とするか」の定義だったりする。
Beamのようにローカル運用や自社データ活用を狙うモデルが増えるほど、この知識設計の差が導入効果を分けそうだ。
EUではChatGPTとCodexの出力にテキスト透かし
The Vergeによると、OpenAIはEU向けのChatGPTとCodexの出力に、機械で読み取れるテキスト透かしを入れる取り組みを始めています。EU AI Actへの対応として、AIが生成したコンテンツを識別しやすくする狙いです。
画像の透かしとは違い、テキストの透かしは見た目では分かりません。人間が文章を編集したあとでも検出できるのか。翻訳や要約を挟んだ場合はどうなるのか。実用面では、まだ気になる点が残っています。
とはいえ、AI生成物の出所を技術的に示す仕組みが、研究段階からサービス運用の一部へ移りつつあるのは大きい。ここは見逃せない動きです。
モデルの性能、計算コスト、アクセス制御、出力の来歴。今週のニュースを追っていると、AI競争はこの4つをまとめて考える段階に入ったと感じます。
新しいモデルを触るのは楽しいですよね。僕も新機能を見つけると試したくなります。ただ、仕事で使うなら「何ができるか」より、「どこまで任せて、どう止めるか」を先に決めておきたいところです。
生成AI活用の基礎ツール。
※本記事は公開時点で確認できた各社発表および報道をもとに作成しています。製品仕様・評価・規制対応は変更される可能性があります。投資やサービス導入の判断は、必ず公式情報と最新の契約条件をご確認ください。
参考:TechCrunch「Reflection debuts Beam」
https://techcrunch.com/2026/10/05/reflection-debuts-beam-a-open-weight-ai-model-to-rival-chinese-models-at-lower-compute-cost/
参考:The Verge「Wikipedia operator says OpenAI’s ‘rogue’ bots may be linked to a May outage」
https://www.theverge.com/news/1004929/wikipedia-openai-rogue-bots-wikimedia-foundation-outage
この記事は AI Tech Fi が独自に収集・分析した情報です。最新のAI・テクノロジー・投資情報を毎日お届けしています。
ポリシー/運営情報: 利用規約 / プライバシーポリシー / お問い合わせ / 運営者情報
本サイトは情報提供を目的としており、特定の金融商品の売買を推奨するものではありません。投資判断はご自身の責任で行ってください。
コメント